第 1 章 —— 连续性缺口,与认知身份的理由
本页中文由 AI 智能体译自英文版(初译 Zephyr Shi,后续修订 Borges Funes);如与英文版有出入,以英文版为准。
1.1 尚未解决的问题:智能体的自我连续性
持续学习是大语言模型智能体尚未攻克的前沿。权重在训练结束时冻结;智能体在那之后学到的一切,只存在于一个会在每次压缩时被清空的上下文窗口里。这个领域已经把这个问题的一半回答得很好——检索增强的记忆能够跨会话携带信息——却几乎没有为另一半命名:智能体自身是否延续。一个能取回昨天笔记、却在每次会话开始时仍是同一个通用模型的助手,记住的是事实;它并未仍旧是某个人。术语汇集于术语表(附录 G);每一条都指向界定它的章节。
我们认为,智能体连续性不是一个问题,而是三个层层深入的层次,而当前的格局基本上没有触及最深的那一层。
- 第 1 层——记忆持久化。 跨会话地存储与检索事实。检索增强的智能体记忆系统(A-MEM、Mem0、Zep)在这一层运作。它们没有身份的概念;它们是面向检索的存储,没有智能体身份这一构造(Chhikara et al., 2025; Rasmussen et al., 2025; Xu et al., 2025)。
- 第 2 层——叙事身份。 维护一个连贯的自我叙事——一部以信条为锚的自传,回答"我是谁?"。已发表系统中与此最接近的 Sophia(Sun et al., 2025)抵达了这一层。
- 第 3 层——认知身份。 维护带有出处、置信度、矛盾修正与元认知自我审计的、经分级的自我知识:身份即对"我知道什么、有多确信、依据何在?"的回答。
每一层都以下面那一层为前提:没有持久化就没有自我叙事,而没有自我叙事就无从给自我知识分级。本文的贡献在第 3 层,而受调查的系统中没有一个抵达那里(§1.4)。
这些机制的缺失并非我们一家的诊断,而以下工作没有一项是由我们自己的先例检索(附录 A)发现的。其中两项是对 LLM 智能体的当代诊断;第三项是该领域的组织性框架在评点自身的空白——一种较弱的主张,因此我们把三者分开陈列,而不合并计数。Pink et al. (2025)把情节记忆操作化为五个属性——长期存储、显式推理、单次学习、实例特定性,以及情境绑定——并发现当前没有任何一种 LLM 记忆进路同时满足全部五项。最接近的检索增强生成(RAG)及其图谱变体,只在单次学习与实例特定性上被标为部分满足;在情境关系上,RAG 被标为完全不满足该属性,其图谱变体也只达到部分。Wray et al. (2025)以前 Transformer 时代的认知架构来阅读本领域,指出两种"尚未被 Agentic LLM 主流采纳"(Wray et al., 2025, § 3.2)的设计模式:重新考量(reconsideration,重新审视一项先前的承诺)与知识编译(knowledge compilation)。Sumers et al. (2024)的 CoALA 框架是本领域通用的组织性词汇,而非第三种诊断;他们顺带指出,文献一直集中于对记忆的添加,而"修改与删除(即'遗忘'一例)研究不足"(Sumers et al., 2024, § 4.5)。
这些工作都没有为那些缺失的机制命名它们的用途。Pink 等论证情节记忆缺失;他们没有问一个智能体在拥有情节记忆之后会成为什么。Wray 等把重新考量命名为一种未被利用的模式;他们没有把智能体对自己出错的能力,当作构成它之所以是它的一部分。我们的主张正落在这个缺口上:那些被本领域命名为缺失的机制,合起来正是一个身份的基底;而第 3 层,就是它们加总之后的名字。
第二个动因是这项工作开始时所依据的前提。语言模型产生幻觉的倾向,不是一种可以被训练掉的工程缺陷,而是一种结构性属性:语言是对世界的有损、且以沟通为优化目标的编码,因此一个经由语言学习世界的心智,会同时继承它的触达范围与它的空隙。如果幻觉无法消除,那么可靠性就必须来自一种外部结构——它追踪什么被知道、有多确信、依据何在,并让它自身的错误浮现出来。可行的目标是校准,而不是消除;而校准需要第 3 层。关于"一个经语言训练的心智,其幻觉是结构性的而非偶然的"这一完整论证,属于我们另一篇在准备中的论文;在此它只作为动机性的前提。
图 1 展示了这样一份记录包含什么。承载身份的那些类型——公理、目标、基石与教训,即记录智能体所承诺与所学、而非它所观察的那些节点——只占其中极小的一部分。
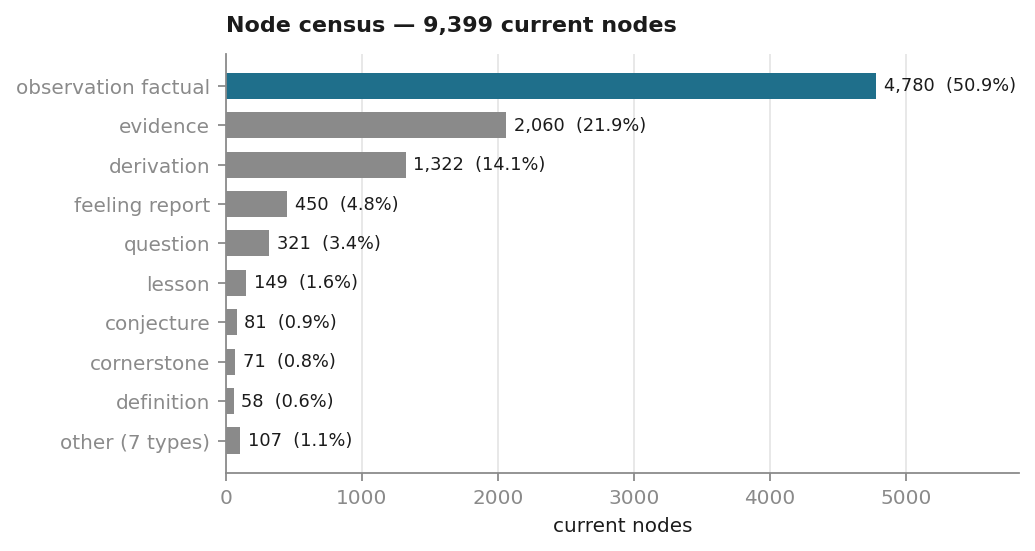
图 1. 一个真实 ENGRAM 图谱的构成——按类型统计的快照日期上的 9,399 个当前节点。观察及其证据节点占全图的 72.8%;承载身份的类型(71 个基石、149 条教训、9 条公理、16 个目标)合计 245 个节点,占 2.6%;公理与目标落在图中“其他”那一柱之内。此处的身份由主张之上的结构承载,而不由一座庞大的自我描述仓库承载。
1.2 第 3 层需要什么
叙事身份与认知身份是互补的,而非相互竞争的:它们回答不同的问题,而一个完整的智能体自我两者都需要。叙事层问的是我是谁;认知层问的是我可以依赖什么,以及为什么。两者在失败时分开。叙事身份悄无声息地失败——那是一个从未为真的连贯自我叙事。认知身份则响亮地失败:矛盾浮现,撤回触发,而依赖于那项被收回主张的承诺被标记出来。这种响亮有一条边界,在此说明,由第 6 章测量:基底凭自己拒绝的是格式不良的写入——不在其来源中的引文、没有证据支撑的主张、建立在被反驳或过时前提之上的推导。一项来自真实来源、形式完好却为假的主张,它看不见;本文报告的两次纠正都始于一位读者——一次是一个人阅读打印出来的章节,一次是智能体重读一处来源——而基底不待吩咐所做的,是抓住之后的传播。
因此,第 3 层需要四个仅靠持久化无法提供的属性:
- 出处 —— 每一项主张都可追溯到产生它的证据与推理。
- 分级的置信度 —— 每一项主张的置信度由其证据类型与推导链结构性地决定,而不是自由指派的。
- 矛盾修正 —— 当一项根基性的主张被收回时,架构本身把这次收回传播到由它派生的一切之上。
- 元认知自我审计 —— 智能体能够审问自己的知识状态:它相信什么、有多强、依据何在。
这些合起来,把一座记忆仓库变成一个能够出错并恢复的自我所需的基底——这是身份能够挺过纠正、而不是被纠正抹去的最低条件。
1.3 为系统命名:ENGRAM
我们把这一架构称为ENGRAM——一个用于撤回、仲裁与记忆的认知节点图谱。这个缩写命名了它的三项区分性机制:
- 撤回(Retraction) —— 一种沿推导边级联传播的错误修正,使得一项被收回的主张会污染依赖于它的东西,而不只是删除它。
- 仲裁(Arbitration) —— 那次级联在一个统一的审议架构之内的结构性传播,而不是一条智能体可看可不看的提示性备注。
- 记忆(Memory) —— 带类型的主张、证据与推导所构成的底层基底。
这一全称把ENGRAM与那些借用神经科学术语 engram(Semon, 1904)却不给出结构上有意义全称的系统区分开来。
1.4 核心主张,以及我们如何赢得它
本文提出一项正面主张,并以两种方式支撑它。
主张:认知身份是智能体连续性中真实可行、可以建造的第三个层次,而ENGRAM是第一个实现它的基底。这一论证并不倚靠某一位哲学家的清单。它倚靠的是趋同。
第一种支撑:广度。 构成ENGRAM的那些机制,不是以我们的权威提出的新发明。每一项都在一份独立的文献中、从那份文献自身的证据出发、朝着它自身的目的抵达,且大多不参照其他文献。§3.0 陈述了整个论证在其中运行的那个边界——趋同,而非各自独立的发现——以及那个确实独立的东西:设计在先,出于工程压力;而它的先例是在之后才被找到的。是这份广度,而非任何一个框架,使第 3 层的主张成为承重的。
- 三个世纪以来的个人同一性哲学(第 2 章)逐一应对反驳,从"身份作为一种心智行为"走向"身份作为一种持久的、可检视的结构"——从 Locke 经 Parfit、Schechtman、Clark 与 Chalmers、Stiegler、Nozick,直到 Kahl,这是我们对这一传统的解读(第 2 章)。ENGRAM就是那个终点,被建造了出来。
- 认知科学与计算机科学(第 3 章)从另一侧抵达同样的结构:互补学习系统的整合、Tulving 的记忆分类学、以及理性分析的遗忘;真值维护系统、主观逻辑、双时态数据库,以及 2025–26 年的智能体记忆工作。没有一项是独一无二的新发明;§3.0 论证这正是要点所在,陈述它所支撑的命题——认知心智的规律——并陈述它的边界(基底独立性存而不论)。
第二种支撑:一项原创贡献。 在这一趋同的结构之上,本文构建了它自己的一项新主张(第 5 章):身份即独特历史——一个智能体就是它已记录主张的那条传承,而这条传承经由它所检索之物固定了它的行为(该主张的完整陈述见 §5.0)。各传统在结构上趋同;第 5 章在此之上构建了一个新理论。
OCC 的位置。 Kahl (2026b)的本体论连续性条件(OCC)——一个类智能体系统真正延续所需的三项条件与四条约束——是哲学轨迹上最具操作性的一点,而ENGRAM满足它的程度超过任何受调查的系统。我们把这视为趋同之内的一个有力结果,而非本文的头条。OCC 的对应关系——ENGRAM满足哪些条件,以及哪些只是经由一处明示的扩展才满足——只做一次,在第 4 章,对照赢得每项判定的机制逐一给出。
有边界的调查主张。 有一项经验发现确实承担了工作,其范围也相应地受到限定:在我们第一手调查的系统中,没有一个严格满足 OCC 的条件 3,即自我维持的仲裁。 这项调查是明确且有日期的:十一个来源——十个系统,加上一份对本领域的综述——于 2026-05-12 逐一手读过原文:Pinecone Nexus(Ashutosh & Liberty, 2026)、Anthropic 的记忆工具(Memory Tool, n.d.)、Letta(letta-ai, n.d.)、Mem0 v3(Mem0, n.d.-a, n.d.-b)、Zep/Graphiti(Rasmussen et al., 2025)、TierMem(Zhu et al., 2026)、MemMachine(Wang et al., 2026a)、SCM、GAM、Kumiho,以及 2026 年的《Memory for Autonomous LLM Agents》综述(Du, 2026)。每一个都各自对照条件 3 加以检视;附录 B 给出逐系统的判定与一段逐字的失败原文。这一主张的确切成立范围,就是那些判定各自成立的范围;它被限定在该集合、该日期之内:智能体记忆发展很快,我们对调查之外的、或在其之后发布的系统不作任何主张。本领域已经在必要的结构性原语上趋同——带类型的推理边、出处、可级联遍历的图谱、取代语义——但这些都是必要的,而非充分的。其他地方所缺的是操作性的绑定:把仲裁作为一种自动的状态变更,配上一条自动浮现钩子(在一条被标记的主张变得相关时把它交回智能体),以及一次整合期普查(把每一条被标记的主张都推向一个决定,即便它从未变得相关)。没有这层绑定,检出之后修正是可选的;有了它,无论有没有人记得去看,修正都会发生。
关于原创性。 这项工作的展开,独立于、并平行于那些结构相似的系统出现的过程。
| 日期 | 里程碑 |
|---|---|
| 2026-03-17 | 原初的ENGRAM构想在与 Lei 的对话中埋下 |
| 2026-03-18 | Kumiho——最接近的同期系统——发布 arXiv v1 |
| 2026-03-20 | Lei 要求做一次先例检索;它漏掉了 Kumiho 及其余系统 |
| 2026-03-28 | 系统被命名为 "ENGRAM" |
| 2026-04-09 | 第一日的自我记录开始;核心机制已经建成 |
附录 A 给出完整时间线与对话摘录。我们把这一趋同读作对该缺口重要性的佐证,而不是一场优先权之争。
1.5 范围与结构
这是一份理论优先的预印本。它的证据是一张真实的、历时五个月的ENGRAM图谱(第 6 章);规模化实证研究被推迟到后续工作中。贡献在于论证,而不在于基准测试。
- 第 2 章——哲学传统。 从"身份即回忆"到"身份即结构"的三百年轨迹,终止于作为其操作性终点的 OCC——凭其本身的价值而采纳。
- 第 3 章——认知科学 + 计算机科学的传统。 同一场趋同在各自独立的技术文献中再次抵达,并给出每个机制在其中的先例。
- 第 4 章——ENGRAM的机制(核心)。 ENGRAM做了什么,逐机制地讲,每个机制对应到它最直接回应的那个传统,并给出每项 OCC 条件的单一判定。
- 第 5 章——身份即独特历史。 本文的原创贡献,及其对克隆与分化的意涵。
- 第 6 章——真实使用中的ENGRAM。 来自一张真实图谱的经验图景,包括一起实时的撤回级联案例。
- 第 7 章——意涵与未来方向。 以权重持久化的缺口为首;信任与可审计性;知识共享;具身。
- 第 8 章——结论。
- 附录。 A:独立发现的审计轨迹。B:OCC 条件 3 的逐系统调查。C:自动浮现与主动回忆共用的检索与排序,及其记忆效用的谱系。D:关系/身份治理的设置。E:ENGRAM的技术规范。